
录音棚笔记
AI 说唱视频首轮实测:输入照片、成片与费用
查看本站真实照片说唱测试:原始人像、约 15 秒成片、模型费用估算,以及衣服标记和背景杂字等实际问题。
AI Rap Video Pro · 2026年10月23日
这次实际测试了什么
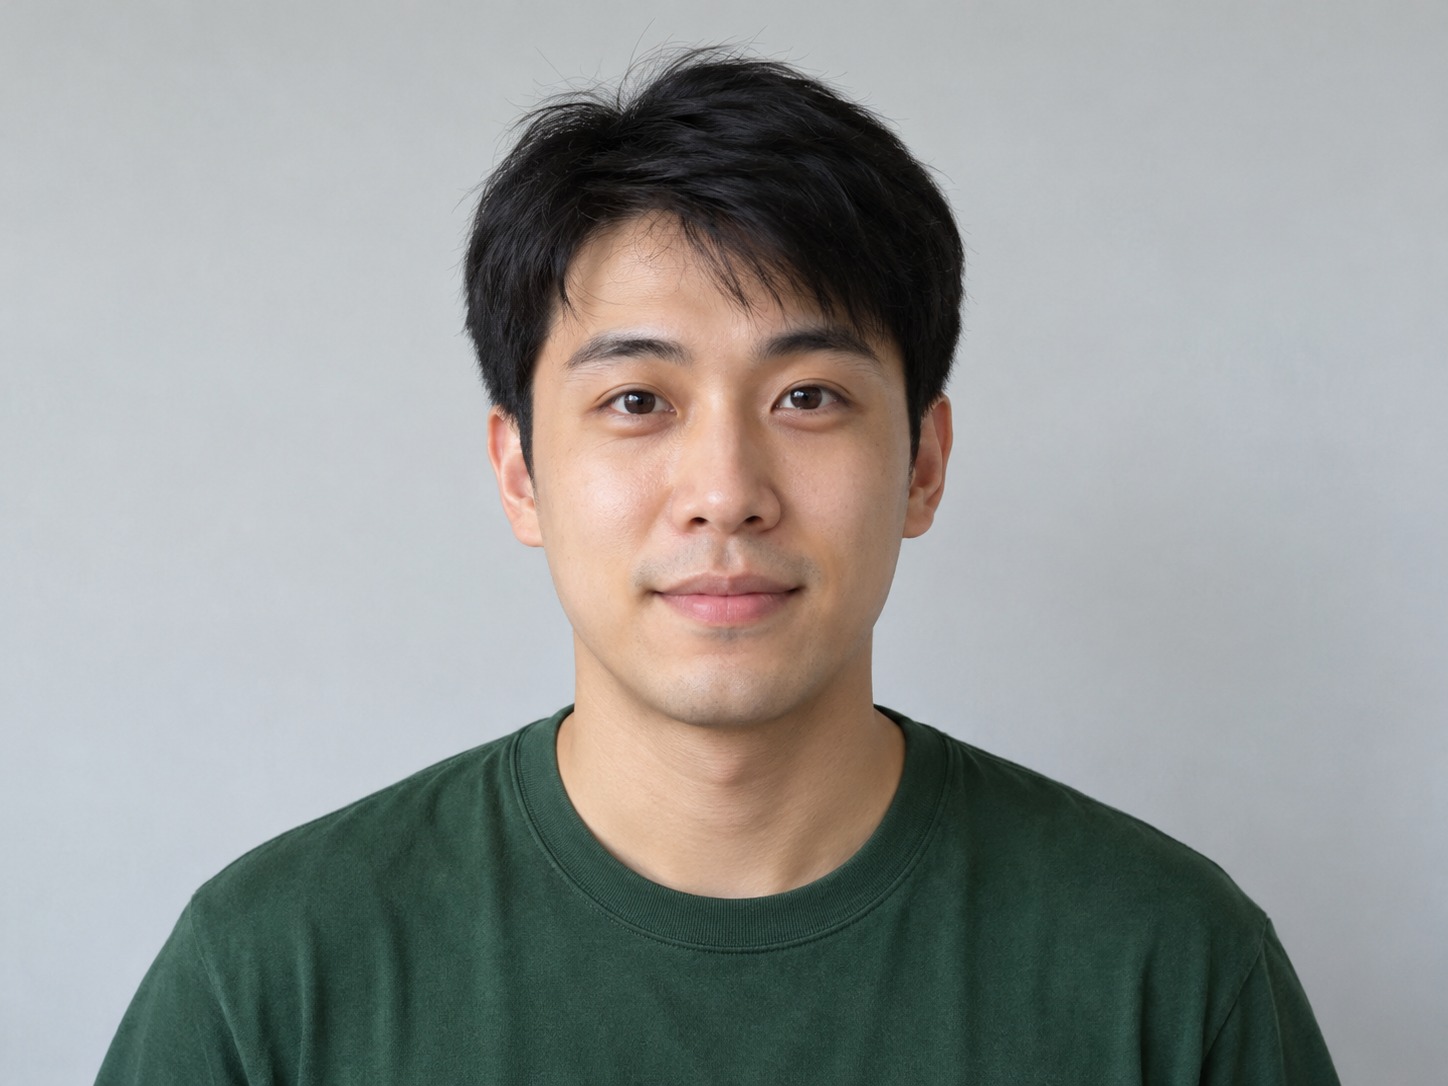
2026 年 10 月 23 日,我们先生成一段原创橙色录音棚说唱表演,再用另一张照片替换参考视频中的人物。两位人物均是为本项目生成的虚构成年人。下方是第二次模型调用的真实输出,只做了适合网页播放的压缩,没有修掉画面瑕疵或替换声音。
这是一次由开发者操作的 API 实验,不是已完成的用户支付流程,也不是对私有上传和下载服务的整体验收。在完整流程和输出质量通过检查之前,公开工作室仍处于预览阶段。
成片背后的两次模型调用
首先,Seedance 2.0 Fast 根据虚构录音棚人物照片及原创四行英文说唱提示生成参考表演,输出包含视频和音轨。随后,我们在本地将参考文件规范为整 15 秒、30 fps,再用它做人物替换。
第二步,将参考视频和上方的新照片交给 Wan 2.2 Animate Replace。设置为 720p、开启 merge_audio、关闭 go_fast、固定 seed 为 42。这个流程更换人物,保留参考表演及其声音,不会把新人物的脸变成其本人真实声音的表演。
| 阶段 | 供应商生成耗时 | 输出 | 费用估算 |
|---|---|---|---|
| 原创参考表演 | 195.5 秒 | 720p、约 15 秒,包含声音 | $2.25 |
| 照片人物替换 | 221.3 秒 | 1280 × 720、14.967 秒、H.264/AAC | $0.75 |
| 本次两次调用 | — | 一段参考表演与一段替换成片 | 预计 $3.00 |
估算依据是测试当天查看的 Seedance 与 Wan 公布价格,尚未与实际账单核对,也不是用户购买价格。这些时间仅代表两次供应商任务,不能当作承诺的交付时间;上传、排队、本地规范和应用处理还会增加等待。
哪些有效,哪些仍有问题
新照片中的人物进入了橙色录音棚,麦克风、整体场景和表演动作得到保留。输出有音轨。本地语音识别从参考及成片中恢复了原创歌词的大部分内容,最终 MP4 也在浏览器中播放到结束。
同时,画面存在可见瑕疵:模型生成了未要求的衣服小标记和背景杂字,人物的脸型与表情在过程中也有变化。声音固定来自参考视频,因此更换照片并不会让声音匹配新人物。这些都是分享前要检查的限制,演示中不应隐藏。
有音轨、能大致识别歌词,并不等于音质已验收或口型逐字准确。本地转写没有准确恢复每一句,这既可能受转写模型影响,也可能受生成声音影响。嘴部动作和快速音节仍需要人工认真检查,播放器内的英文字幕也仅是对应原创提示歌词的近似辅助。
对你的输入照片有什么启示
尽量选择只有一位成年人的清晰照片,光线均匀,嘴部无遮挡。照片提供人物,参考表演则决定较多的场景、动作与声音。不要仅凭“生成器”三个字,就以为它已支持任意歌词或任意声音。可以先看照片检查清单及模板、人声与口型说明。
这只是一次测试,不是覆盖不同人物、姿势和光线的基准。我们尚未得出成功率,也没有证明所有照片都能达到相同效果。因此,完整私有流程和输出质量验证通过前,生成及购买入口继续关闭。